

 Return
百曜发布|新 SOTA!首个虚拟细胞世界模型 AURA CellOS 发布,开辟行业 2.0 时代
2026年09月20日 News and Research
近日,专注于AI虚拟细胞(AIVC)平台研发的科技公司百曜科技(Vitaura)正式发布新一代虚拟细胞模型AURA CellOS(以下简称“CellOS”),该模型率先探索将世界模型(World Model)理念引入 AI细胞基础模型,以多视角表征学习和JEPA(Joint Embedding Predictive Architecture:联合嵌入预测架构)为核心技术路径,实现对细胞状态的统一建模。
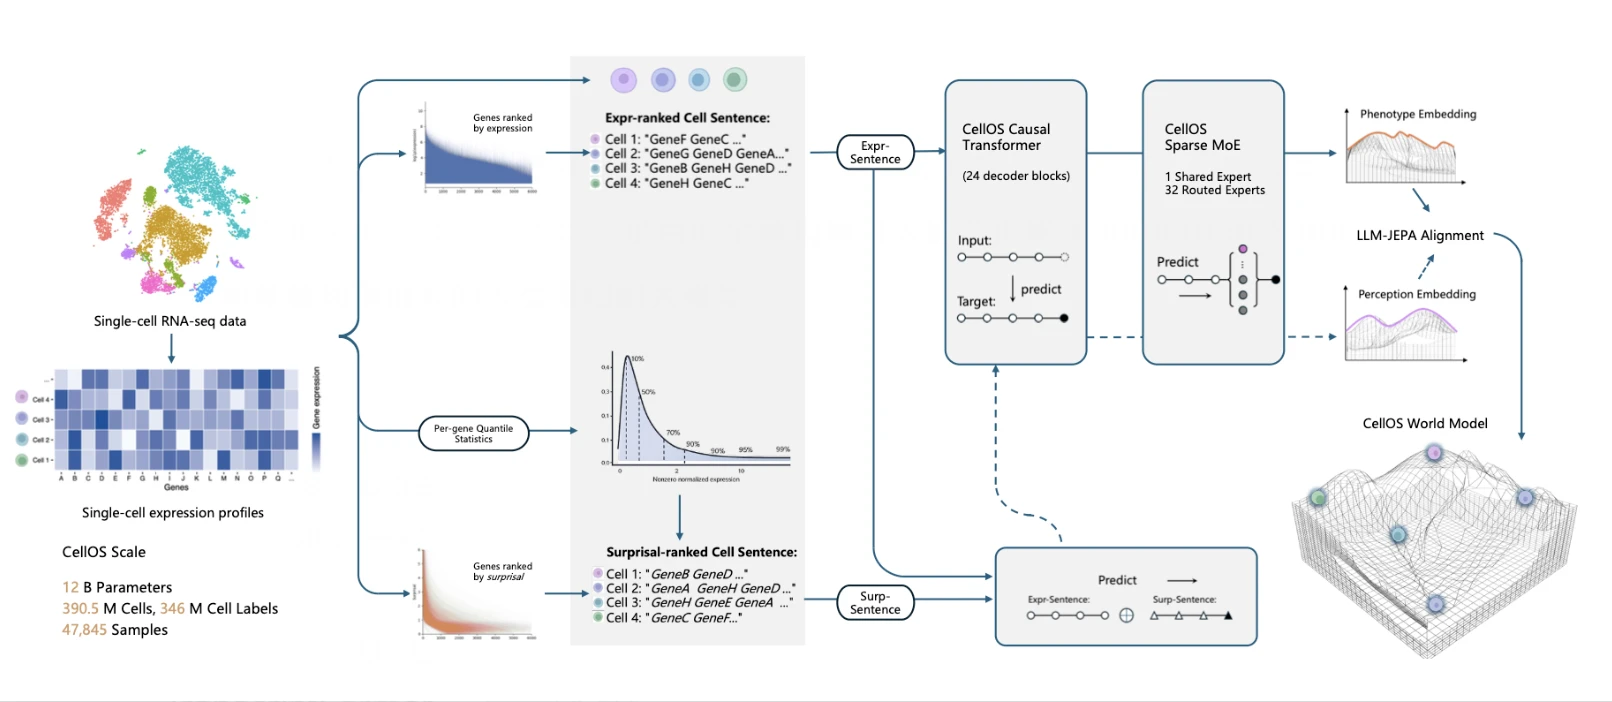
需要强调的是, CellOS 是基于 3.905 亿个人类单细胞转录组训练的 12B 模型,覆盖了几乎所有重要的人类细胞类型,是目前全球规模最大的单细胞 Foundation Model,也是目前参数规模最高的人类单细胞大模型。
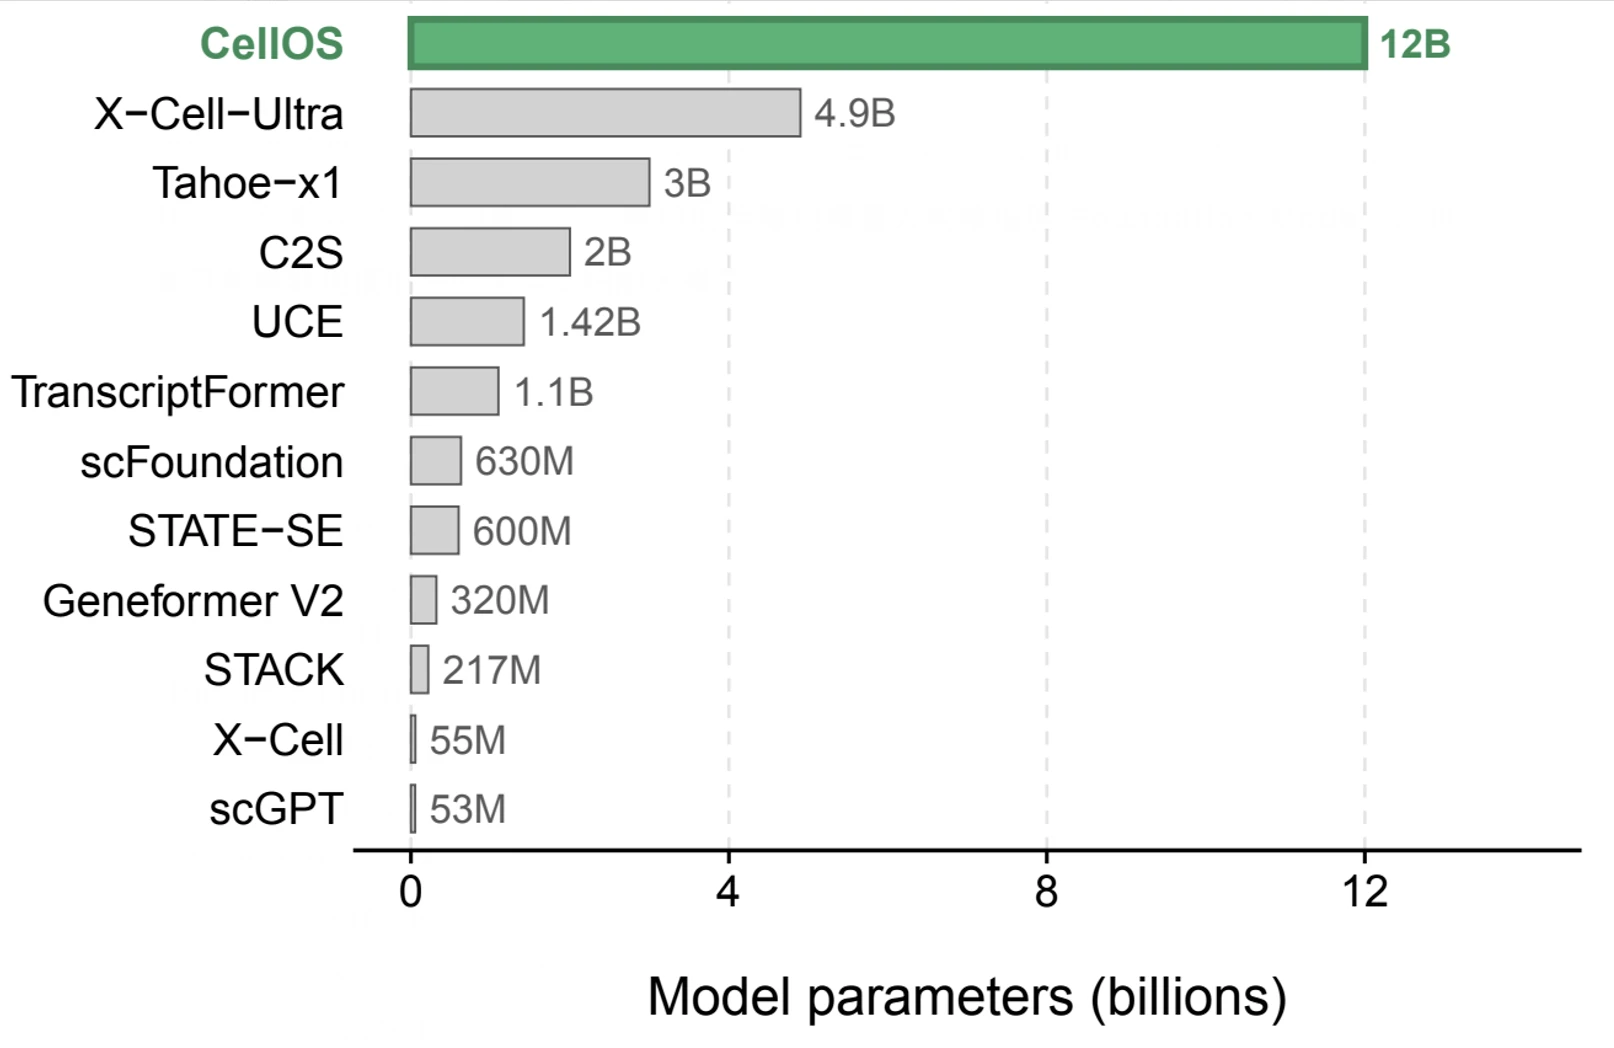
多项标准评测结果表明,CellOS整体性能达到当前最先进(State-of-the-Art,SOTA)水平,尤其在细胞状态注释和扰动响应预测方面断崖式领先,与多款主流单细胞基础模型拉开倍数差距,同时保持了稳健的批次整合能力。
多视角表征学习与JEPA联合嵌入预测的技术路径,不仅在性能指标上领先,更在医药生物等临床场景中展现出了可迁移的产业价值。
CellOS三段式训练融合三大创新,AI虚拟细胞迈向2.0时代
理解和预测细胞动态演变是生命科学关心的核心命题。过去,面对“敲除某个基因细胞会怎样?”“加入药物细胞如何反应?”这类问题时,研究人员只能依赖动物实验和人体湿试验,周期漫长、成本高昂且伴随伦理与安全风险。细胞研究亟需一种能在数字环境中提前模拟细胞状态演化的工具,AI虚拟细胞(AIVC)由此而生。
随着Transformer语言模型算法能力的积累,以及单细胞测序技术成本骤降、数据量从百万级跃升至亿级,2023年,以Geneformer、scGPT、scFoundation、GeneCompass为代表的第一代AIVC模型问世。模型通过学习细胞表达模式完成细胞状态建模,在细胞类型识别、Annotation等任务中取得了显著进展,随后扩散架构等更多技术路线也被引入这一领域。
然而,第一代AIVC模型的纯语言模型架构与细胞数据特性之间存在系统性错配,导致模型性能随数据量的增长线性提升不明显。今年6月Nature Methods发表的一项研究中表明,基于2220万个细胞预训练的400个模型、完成6400次评估后显示,基础模型在仅使用1%-10%的预训练数据后性能便进入平台期,并未呈现出清晰的Scaling Law效应。
百曜科技认为,Scaling Law在AIVC领域并非是伪命题,而是不能仅在纯语言模型架构的框架内依靠堆砌数据和参数来替代对生物学本质的理解。对此,百曜科技提出的CellOS革新了上一代纯语言模型架构,率先将JEPA(联合嵌入预测架构)引入细胞基础模型,开启AI虚拟细胞的2.0时代。CellOS通过观测维度、AI学习逻辑、模型扩容能力三大创新,让算法架构与生物学机理深度融合。
创新一:表达视角+感知视角双视角,区分基因表达丰度与群体特异性生物学信号。传统模型仅依靠表达视角判断细胞,很容易忽略那些表达量普通、却能标志细胞分化、药物反应的关键基因。CellOS额外增加群体感知视角,将基因表达丰度与其在群体中的信息量拆分为两套互补的判断标准,从而让隐藏在海量背景基因中的调控、应激类关键信号更容易被模型捕获。
创新二:首次引入JEPA式隐空间对齐,让模型从复现输入走向学习细胞状态表征。传统模型训练目标是还原原始基因序列,更容易聚焦于输入表达模式本身,而难以学习稳定的细胞状态表征。JEPA不再直接重构原始输入,而是在隐空间预测另一视角的细胞表征。这种训练方式让模型跳出表层数据,更好捕获与细胞状态变化相关的稳定生物学信号。
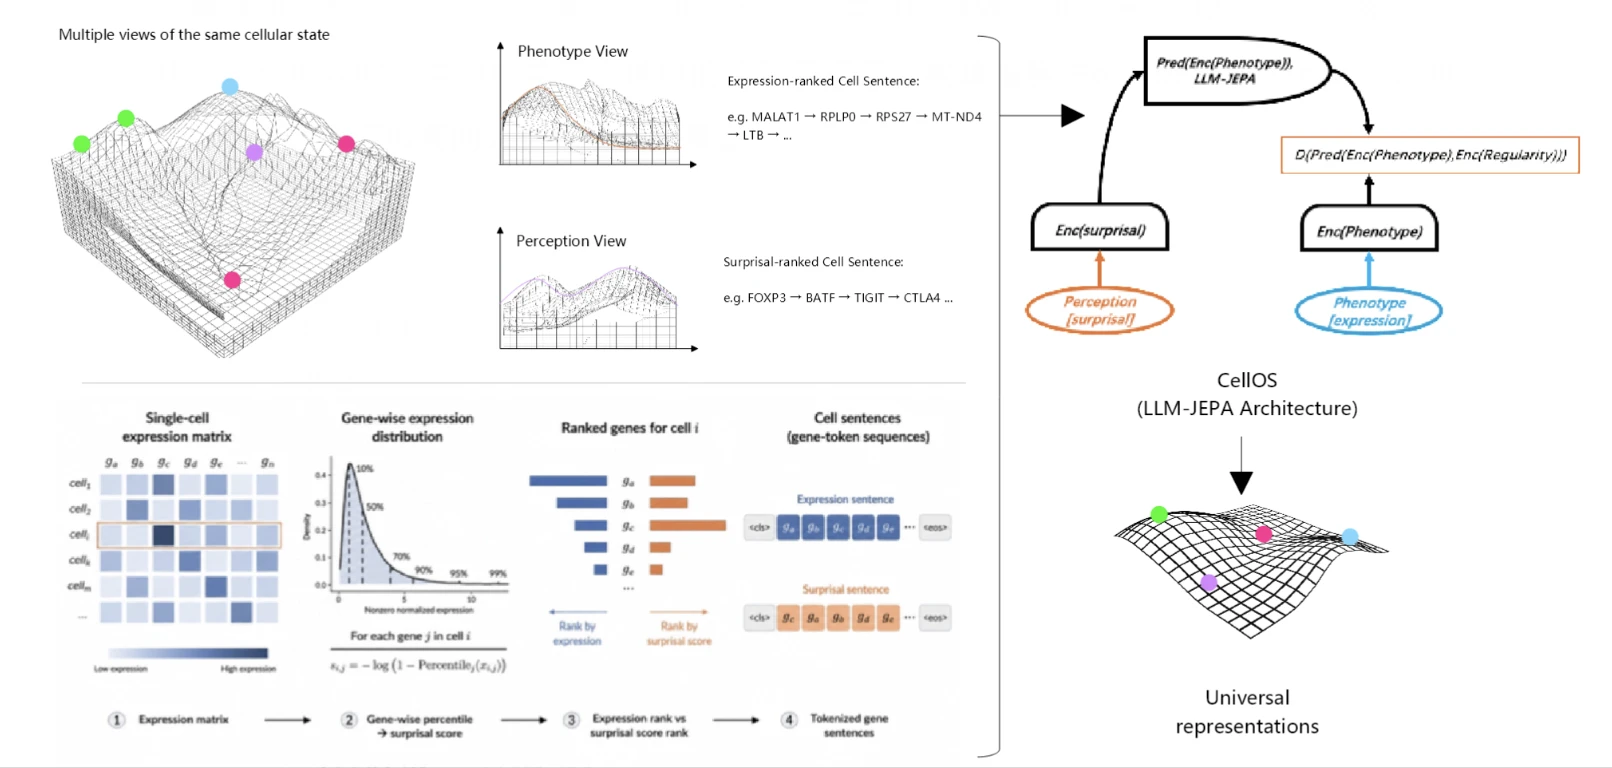
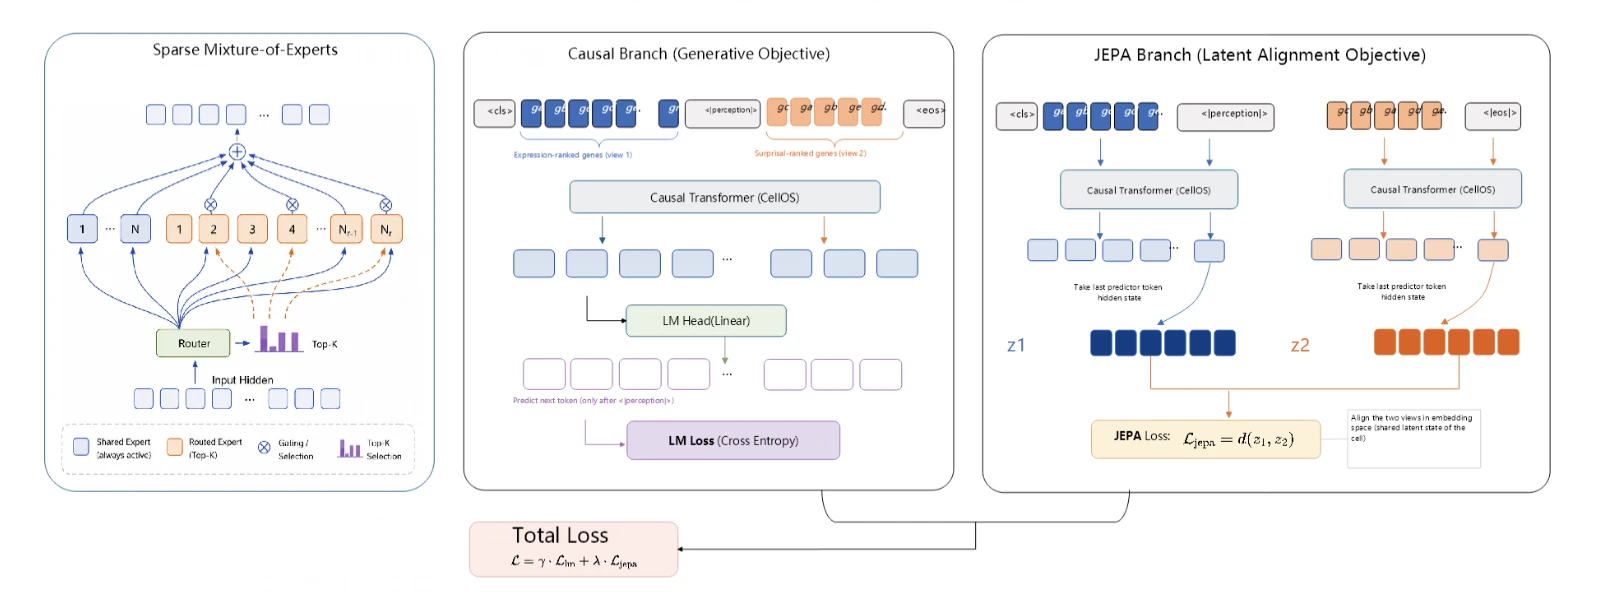
创新三:自研无损扩容训练方案,兼顾模型规模扩张与已有知识留存。模型一旦扩大参数容量,容易遗忘前期学到的细胞表达规律,难以驾驭亿级海量细胞数据集。CellOS采用稠密模型平滑升级混合专家模型的方式,扩容过程尽可能保留前期训练积累的表达规律,最大程度降低能力衰减风险。
上述三大创新旨在让模型从“复述数据”转向“理解状态”,从而具备捕捉细胞状态变化背后生物学规律的能力。然而,这一转变难以通过单阶段训练完成,为此,CellOS将训练拆解为三个循序渐进的阶段,每个阶段承载特定的学习目标,并由专用数据引擎提供规模化支撑,使数据价值得以充分释放。
阶段一:稠密模型预训练阶段,先训练一套完整的稠密基础模型。采用稠密Transformer架构,仅用表达视角+LM损失预训练。让AI先学习细胞中基因表达排序与共表达规律,为后续世界模型学习打下基础。
阶段二:MoE平滑扩容阶段,无损扩容升级大容量模型。把上一阶段练成熟的小模型平稳升级成专家混合大模型,原有学习到的知识完全保留。基础能力共用1个共享专家(初始化复用稠密权重),额外新增32个专家模块,由模型自动学习不同生物学模式,升级完成后还能继续深度训练。扩容初期模型行为尽可能接近原稠密模型,从而降低已有细胞表达规律被破坏的风险。
阶段三:多视角联合训练阶段,加入第二套观察视角,完成双视角融合学习。新增“群体信息量感知视角”,同时搭配JEPA对齐逻辑训练,让AI把两套视角看到的信息融合统一。
依托三大创新与三段式训练体系,CellOS突破了传统模型静态识别的局限,让AI完成从“表层观测”到“理解细胞状态规律”的跨越,既补齐了传统模型难以捕捉关键基因信号、无法预判动态变化的短板,又通过无损扩容方案保障了百亿级参数的有效训练。这一转变标志着虚拟细胞模型设计理念的分水岭:传统模型以“重构表达谱”为目标,学习的是细胞组成的语法;而CellOS以“对齐互补视角”为目标,学习的是细胞状态的“语义”,真正迈向“细胞理解者”——为预测干预、状态转变和虚拟细胞系统提供可迁移的表征底座。
多基准验证:CellOS断崖式领跑多项准确度测试
CellOS在细胞状态注释、批次整合、扰动响应预测一系列基准测试中验证了这一设计的有效性。
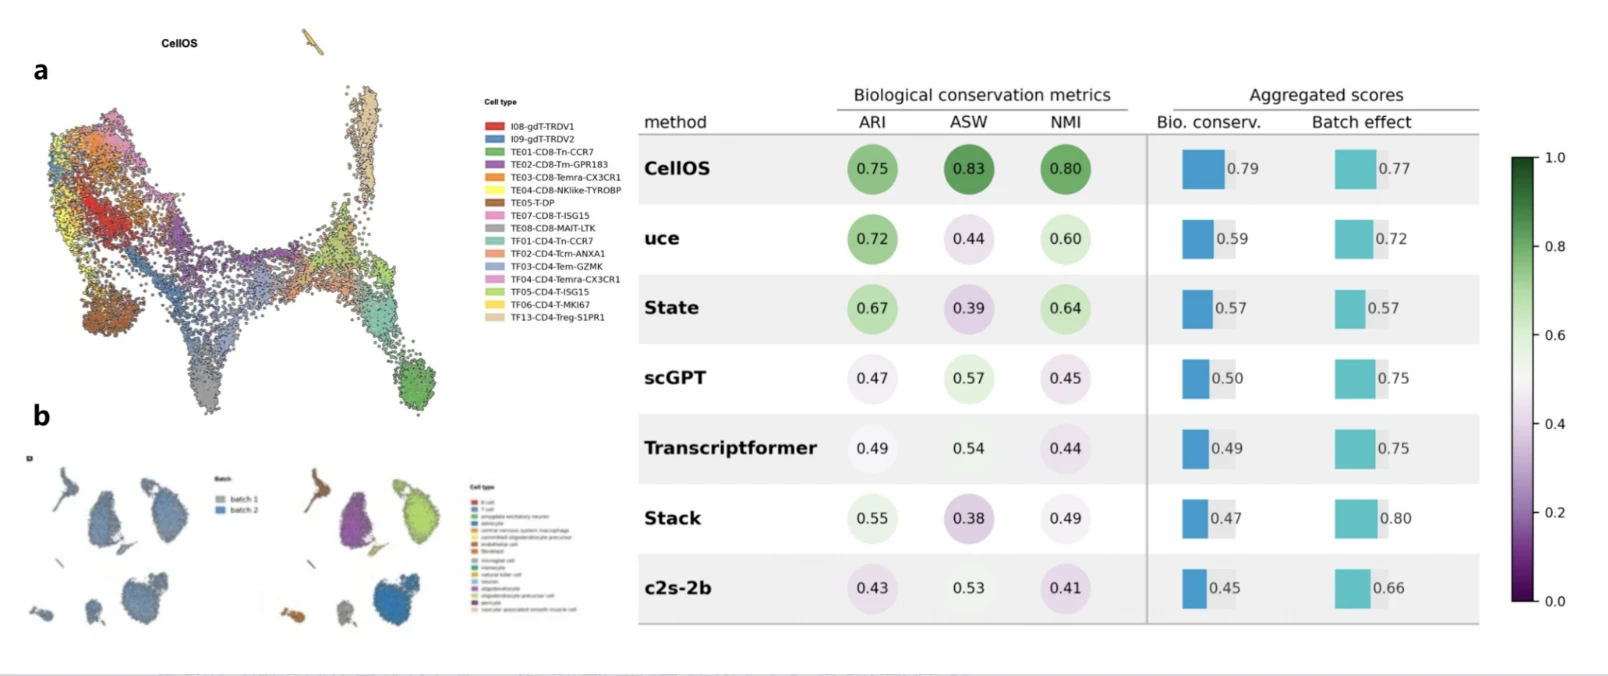
(图:CellOS在细胞状态注释、批次整合、扰动响应预测基准测试中与主流模型的对比实验)
在细胞状态注释任务中,它在聚合注释基准上取得了0.792的生物学保守分数,全面超越UCE、scGPT、TranscriptFormer等主流竞品。面对T细胞亚群、免疫衰老、iPSC分化这类细分难度较高的样本,模型都能精准区分各类细胞状态。
在批次整合层面,CellOS平衡了技术偏差消除与生物学信息保留,虽然批次混合分数略低于STACK,但在减少批次效应的同时,更好保留细胞状态相关的生物学信息,更贴合科研与药企的真实分析需求。
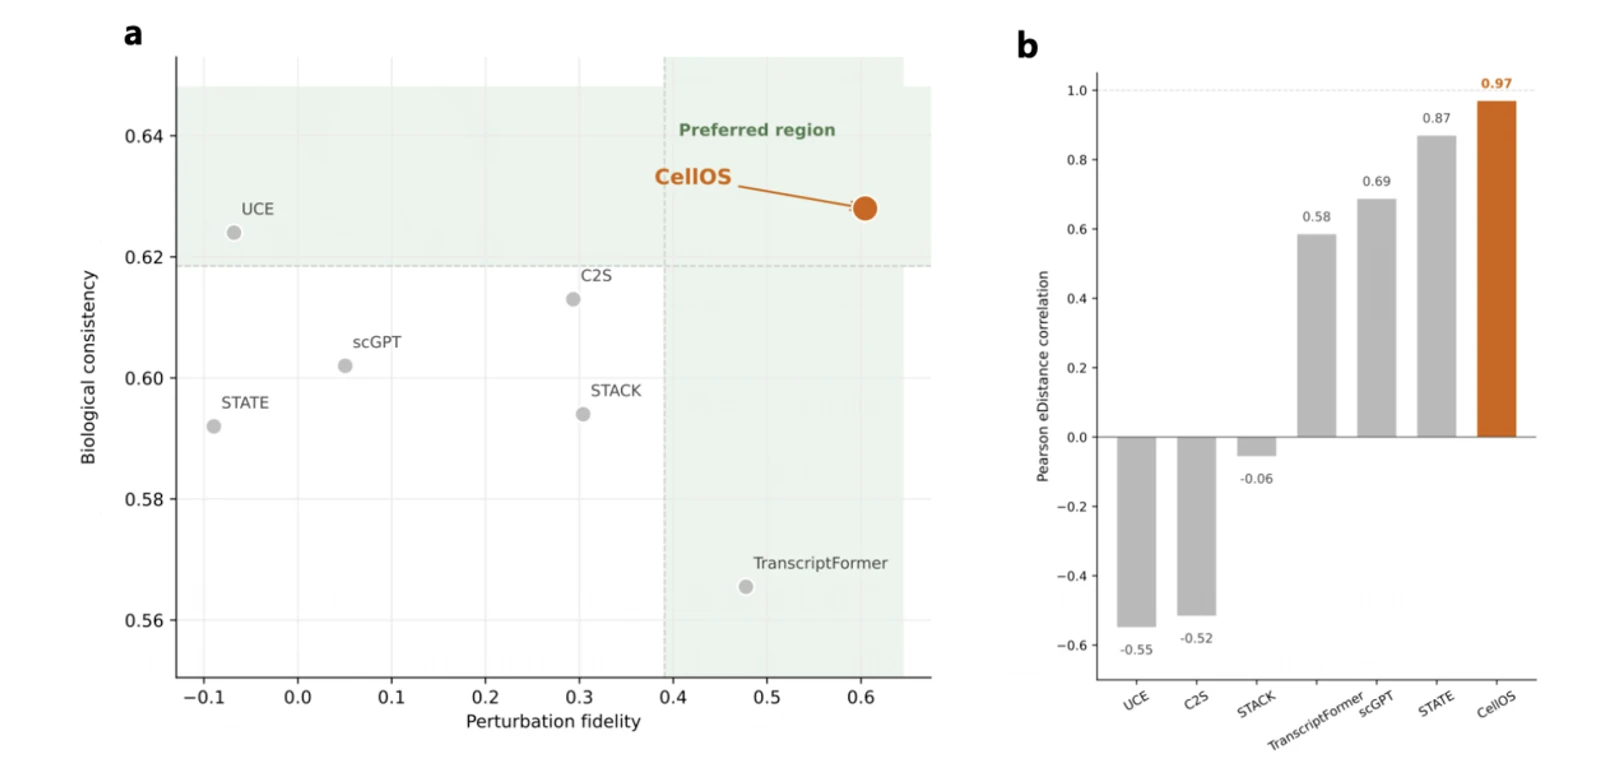
(图:CellOS在药物/基因扰动响应预测与主流模型的横向对比实验)
在衡量细胞状态预测能力的核心指标 Pearson_edist 上,CellOS取得 0.619 的成绩,不仅位列所有模型第一,也是唯一突破 0.6 的模型,相比目前表现最好的开源模型 TranscriptFormer(0.373)拉开66%的性能差距,形成了明显的领先优势。现有模型还在“及格线”附近,CellOS已经迈入“优秀区间”。需要强调的是, Pearson_edist 并非比较单个基因是否预测正确,而是衡量AI是否预测出了整个细胞状态在扰动后的变化轨迹,也是当前细胞扰动预测最重要的评价指标之一。
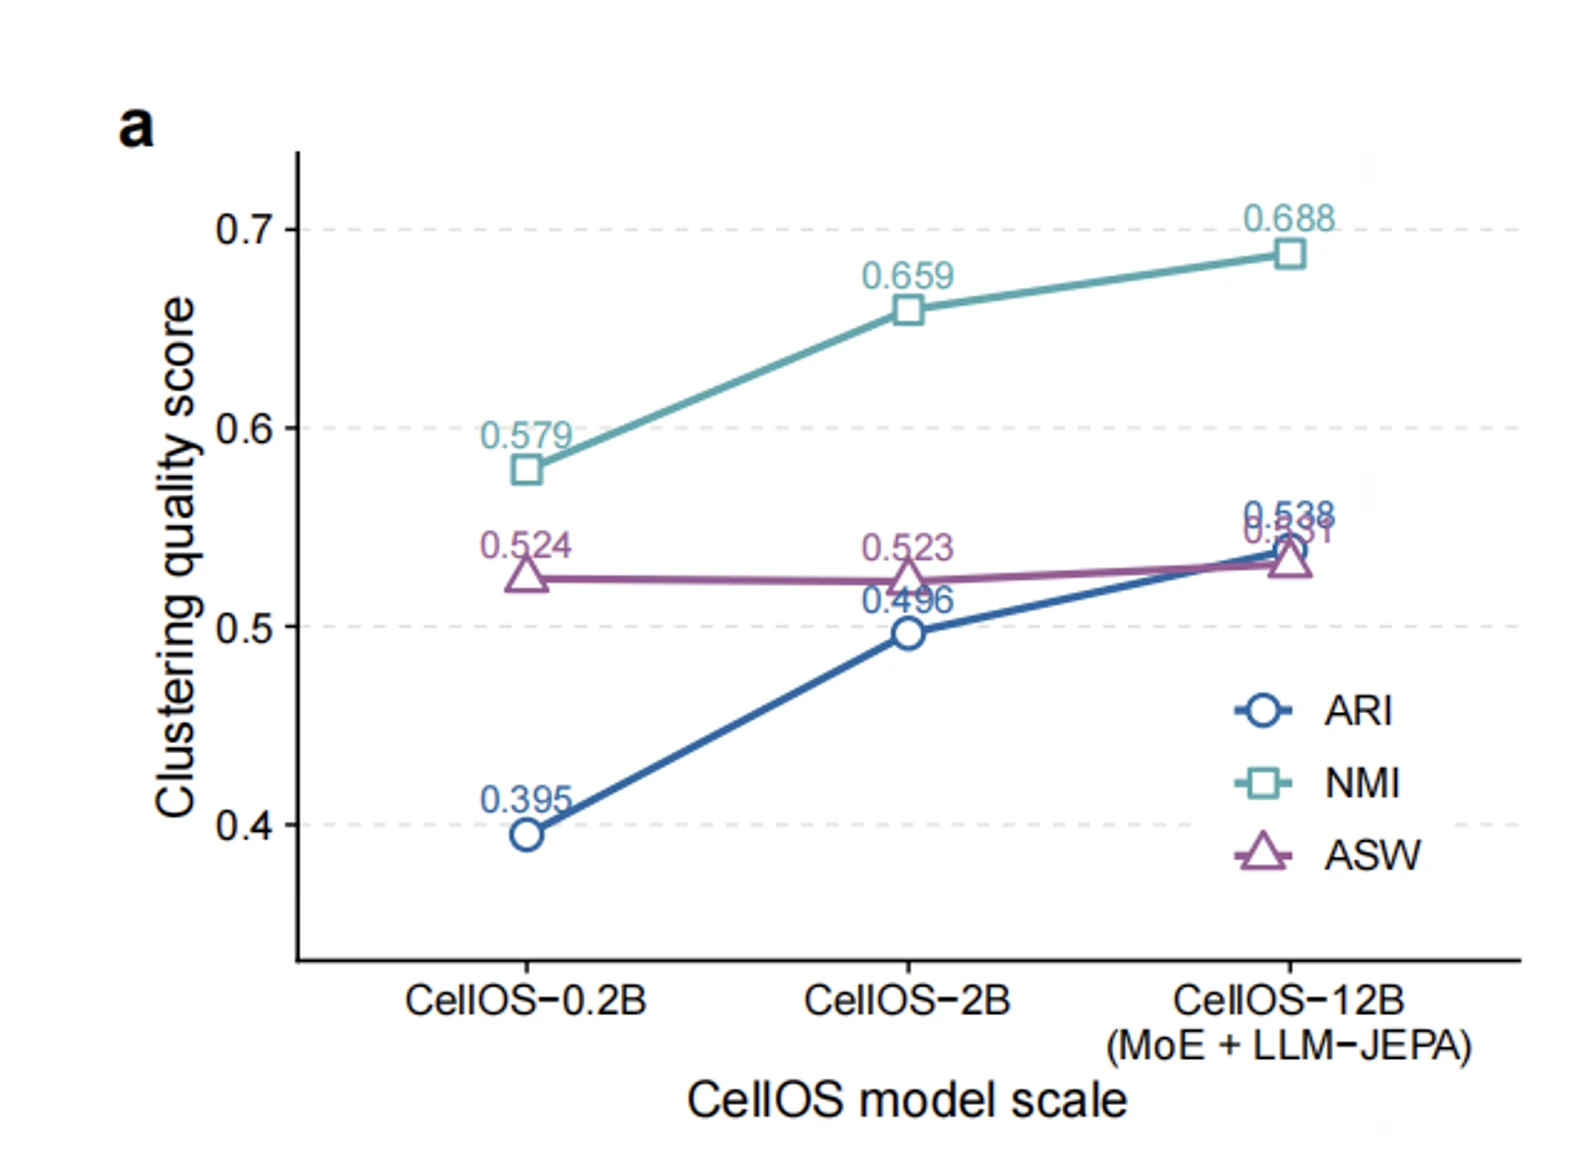
(图:CellOS 模型参数规模消融实验)
参数规模消融实验进一步表明,性能提升既来自参数规模,也来自方法设计。从0.2B到2B再到12B,注释性能随参数增加呈现近似对数线性增长;而第三阶段引入多视角JEPA对齐后,细粒度与稀有细胞状态区分能力进一步提升。
上述结果表明,CellOS的性能提升并非单纯依赖参数规模扩张,而是来自世界模型理念、多视角表征学习与JEPA联合嵌入预测等设计的共同作用,得以让模型真正理解细胞状态的变化规律,从而能够在药物研发、细胞治疗等真实场景发挥重要作用。
聚焦管线资产与模型服务,加速AI虚拟细胞从技术验证走向应用落地
CellOS在细胞状态表征与扰动预测等核心任务上的突破性表现,为药物研发与细胞治疗提供了可靠的预测底座。
为推动AI虚拟细胞从技术验证走向应用落地,百曜科技将与制药企业、CRO/CDMO机构、科研院所、临床机构及产业伙伴共同构建开放协同的虚拟细胞生态。通过开放平台能力、促进数据与模型协作、推动行业标准建设,公司致力于形成覆盖科研创新与产业转化的生态网络,加速虚拟细胞技术在全球生命科学领域的广泛应用。
面向未来,百曜科技将持续推进人工智能与生命科学的深度融合,构建服务于生命科学研究和生物产业发展的基础设施。随着虚拟细胞技术的不断成熟,生命系统将逐步实现从观察与实验到理解与设计的跃迁,生命科学也将由此进入可模拟、可预测、可设计的新时代。
论文链接:
https://www.biorxiv.org/content/10.64898/2026.06.18.733163v2
Share: